Last time I showed a naïve implementation of the Damerau-Levenshtein-Distance in F# that needs O(m*n) space. This is really bad if we want to compute the edit distance of large sequences (e.g. DNA sequences). If we look at the algorithm we can easily see that only the last two lines of the (n*m)-matrix are used. This observation leads to a improvement where we compute the distance with only 3 additional arrays of size min(n,m).
/// Calcs the damerau levenshtein distance.
let calcDL (a:'a array) (b: 'a array) =
  let n = a.Length + 1
  let m = b.Length + 1
  let lastLine = ref (Array.init m (fun i -> i))
  let lastLastLine = ref (Array.create m 0)
  let actLine = ref (Array.create m 0)

  for i in [1..a.Length] do
    (!actLine).[0] <- i
    for j in [1..b.Length] do
      let cost =
        if a.[i-1] = b.[j-1] then 0 else 1
      let deletion = (!lastLine).[j] + 1
      let insertion = (!actLine).[j-1] + 1
      let substitution = (!lastLine).[j-1] + cost
      (!actLine).[j] <-
        deletion
        |> min insertion
        |> min substitution

      if i > 1 && j > 1 then
        if a.[i-1] = b.[j-2] && a.[i-2] = b.[j-1] then
          let transposition = (!lastLastLine).[j-2] + cost
          (!actLine).[j] <- min (!actLine).[j] transposition

    // swap lines
    let temp = !lastLastLine
    lastLastLine := !lastLine
    lastLine := !actLine
    actLine := temp

  (!lastLine).[b.Length]


let damerauLevenshtein(a:'a array) (b:'a array) =
  if a.Length > b.Length then
    calcDL a b
  else
    calcDL b a
This version of the algorithm needs only O(n+m) space but is not really "functional" style. I will show a more "F#-stylish" version in part III.
Tags:
alignment,
Damerau,
damerau-levenshtein,
dna,
dynamic programming,
edit distance,
F#,
Levenshtein algorithm,
Levenshtein distance
Today I am publishing an algorithm for calculating the Damerau-Levenshtein distance in F#. The Levenshtein distance is a metric that allows to measure the amount of difference between two sequences and shows how many edit operations (insert, delete, substitution) are needed to transform one sequence into the other. The Damerau-Levenshtein distance allows the transposition of two characters as an operation. It is often used for spelling corrections or to measure the variation (“edit distance”) between DNA sequences.
let damerauLevenshtein(a:'a array) (b:'a array) =
let init i j =
if j = 0 then i
elif i = 0 then j else 0
let n = a.Length + 1
let m = b.Length + 1
let d = Array2.init n m init
for i in [1..a.Length] do
for j in [1..b.Length] do
let cost =
if a.[i-1] = b.[j-1] then 0 else 1
let deletion = d.[i-1, j] + 1
let insertion = d.[i,j-1] + 1
let substitution = d.[i-1,j-1] + cost
d.[i, j] <-
deletion
|> min insertion
|> min substitution
if i > 1 && j > 1 && a.[i-1] = b.[j-2] &&
a.[i-2] = b.[j-1] then
let transposition = d.[i-2,j-2] + cost
d.[i, j] <- min d.[i,j] transposition
d.[a.Length, b.Length]
This naïve implementation needs quadratic space (O(m*n)). Since the algorithm is used to calculate the edit distance of large DNA sequences this is extremly bad. Next time I will show how we can get linear space (O(m+n)) for the algorithm.
Tags:
alignment,
Damerau,
dna,
dynamic programming,
edit distance,
F#,
Levenshtein algorithm,
Levenshtein distance
Last time I showed how it is possible to use parallel map and fold functions to compute the sum of all factorials between 1 and 3000. The result was a nearly perfect load balancing for this task on a two processor machine. This time I will derive a generic function that computes partial results in parallel and folds them to a final result.
Let’s consider our F# example:
let add a b = a + b
let fac (x:bigint) =
[1I..x] |> List.fold_left (*) 1I
let sequential() =
[1I..3000I]
|> List.map fac
|> List.fold_left add 0I
This is the same as:
let calcFactorialSum min max =
[min..max]
|> List.map fac
|> List.fold_left add 0I
let f1() = calcFactorialSum 1I 2000I
let f2() = calcFactorialSum 2001I 2200I
let f3() = calcFactorialSum 2201I 2400I
let f4() = calcFactorialSum 2401I 2600I
let f5() = calcFactorialSum 2601I 2800I
let f6() = calcFactorialSum 2801I 3000I
let sequential2() =
f1() + f2() + f3() + f4() + f5() + f6()
We spitted the summation into 6 independent tasks and computed the sum of the partial results. This has nearly no bearing on the runtime.
But with the help of PLINQ we can compute each task in parallel:
let asParallel (list: 'a list) =
list.AsParallel<'a>()
let runParallel functions =
ParallelEnumerable.Select(
asParallel functions, (fun f -> f() ) )
let pFold foldF seed (data:IParallelEnumerable<'a>)=
ParallelEnumerable.Aggregate<'a,'b>(
data, seed, new Func<'b,'a,'b>(foldF))
let calcFactorialsParallel() =
[f1; f2; f3; f4; f5; f6]
|> runParallel
|> pFold add 0I
This time we build a list of functions (f1, f2, f3, f4, f5, f6) and run them in parallel. "runParallel” gives us back a list of the partial results, which we can fold with the function “add” to get the final result.
On my Core 2 Duo E6550 with 2.33 GHz and 3.5 GB RAM I get the following results:
Time Normal: 26.576s
Time Sequential2: 26.205s (Ratio: 0.99)
Time “Parallel Functions”: 18.426s (Ratio: 0.69)
Time PLINQ: 14.990s (Ratio: 0.56) (Last post)
Same Results: true
We can see that the parallel computation of the functions f1 – f6 is much faster than the sequential.
But why is the PLINQ-version (see last post) still faster? We can easily see that each partial function needs a different runtime (e.g. it’s much harder to calculate the factorials between 2800 and 3000 than between 2000 and 2200). On my machine I get:
Time F1: 8.738s
Time F2: 2.663s
Time F3: 3.119s
Time F4: 3.492s
Time F5: 3.889s
Time F6: 4.442s
The problem is that the Parallel Framework can only guess each runtime amount in advance. So the load balancing for 2 processors will not be optimal in every case. In the original PLINQ-version there are only small tasks, and the difference between each runtime is smaller. So it is easier to compute the load balancing.
But of course we can do better if we split f1 into two functions f7 and f8:
let f7() = calcFactorialSum 1I 1500I
let f8() = calcFactorialSum 1501I 2000I
So we can get a better load balancing:
Time F1: 8.721s
Time F7: 4.753s
Time F8: 4.829s
Time Normal: 26.137s
Time “Parallel Functions”: 16.138s (Ratio: 0.62)
Same Results: true
Tags:
F#,
Google,
Map and fold,
MapReduce,
Parallel Computing,
Parallel Extensions,
PLINQ
Am Donnerstag war ich auf der Student Technology Conference 2008 in der Berliner Kalkscheune. Nachdem mich mein Navigationsgerät in die Oranienburger Straße in Reinickendorf statt Mitte geschickt hat und ich 10km weiter durch den Berufsverkehr fahren musste, konnte ich in der Kalkscheune gleich meinen ersten Kaffee zum Frühstück trinken. Wie es sich für eine vom Umweltministerium geförderte Konferenz gehört, wurde der in Pappbechern gereicht. 🙂 Im Laufe der Konferenz wurde dieses Missgeschick jedoch bemerkt und seitdem gab es nur noch Keramik.
Insgesamt hat mir die Konferenz sehr gut gefallen und nachdem ich zweimal bereits als Zuhörer auf der STC war, durfte ich dieses Jahr auch mal einen eigenen Vortrag halten. Die Folien dazu können nun hier herunter geladen werden.
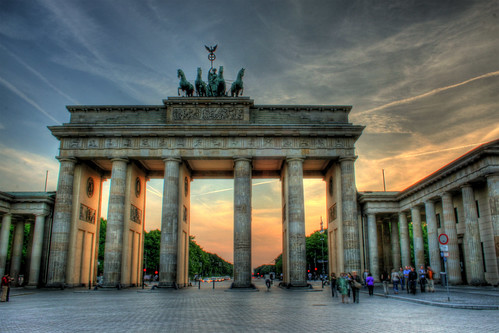
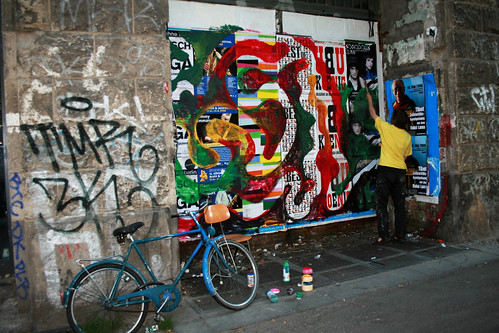
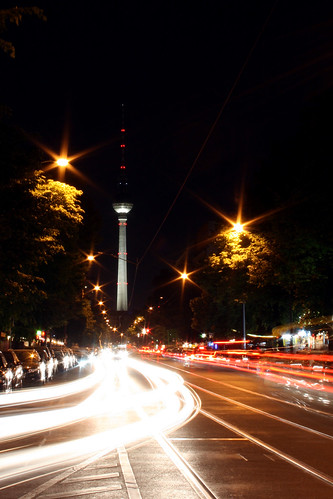
Hier noch ein paar meiner Bilder aus Berlin:
PS: Bilder von der Konferenz werden demnächst sicher unter www.studentconference.de zu finden sein.
Nachtrag: Die Konferenzbilder sind jetzt unter http://www.schmolzeundkuehn.de/stc_2008 zu finden.
Tags:
Berlin,
optimierung,
STC 2008,
Student Technology Conference,
Tourenplanung
Aufgrund einer Sprecherabsage, habe ich kurzfristig einen Vortrag auf der STC 2008 bekommen. Die Veranstaltung steht dieses Jahr unter dem Motto “GreenIT”. Mein Vortrag wird deshalb auch etwas “grüner” als ein “normaler” Navision-Vortrag:
Die strategische Tourenplanung für große Flotten ist ein so komplexes Problem, dass man keine optimale Lösung in vertretbarer Zeit berechnen kann. Der einzige Ausweg führt über intelligente Heuristiken, die in kurzer Zeit Lösungen liefern, die möglichst nah an der optimalen Lösung liegen und damit helfen die Fahrtkosten und den Benzinverbrauch zu minimieren. Der Vortrag stellt einige dieser Verfahren vor und zeigt wie eine Implementation im ERP-System „Microsoft Dynamics NAV“ aussehen könnte.
Gleichzeitig bekomme ich auch die Gelegenheit als einer der ersten die neue Navision-Version “Dynamics NAV 2009” öffentlich zu zeigen.
Weitere Informationen gibt es in der Agenda.
Tags:
Dynamics NAV 2009,
optimierung,
STC2008,
Student Technology Conference,
Tourplanung mit Zeitfenstern
Das Google Maps API ist ein wunderbares Visualisierungswerkzeug für Kartendaten. Letzte Woche habe ich zusammen mit einem Freund, eine GIS-Anbindung an Google Maps probiert. Das Ergebnis mit den Daten von ein paar Bundesländern findet man unter http://www.navision-blog.de/gis/.
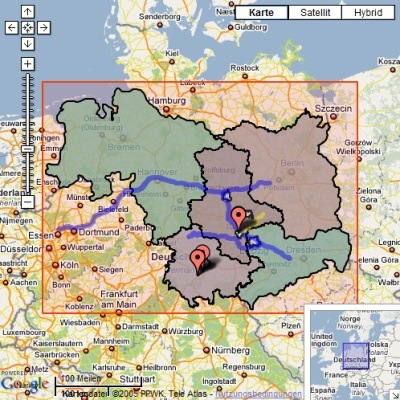
Die interessanteste Erkenntnis für mich war, dass mySQL in der aktuellen Version schon einen ausführlichen Support für Geometriedaten und Geometriefunktionen bietet. Das habe ich bisher nicht bemerkt, da mein myphpAdmin diese Datentypen und Funktionen nicht kennt und deshalb nicht anzeigt. Neben der Umrechnung und komprimierten Speicherung von Geoinformationen kann mySQL z.B. auch berechnen, ob sich zwei Polygone schneiden.
Im SQL Server 2008 wird im Zusammenhang mit Geoinformationen übrigens auch eine ganze Menge getan. Wer Interesse daran hat, kann sich zum Beispiel einen kurzen Webcast dazu ansehen.
Tags:
Geometrie,
GIS,
Google Maps,
mySQL,
SQL Server 2008

Dieses Jahr findet die STC am 15.05.2008 in der Kalkscheune in Berlin-Mitte statt. Demnächst werden weitere Informationen unter http://www.studentconference.de/ veröffentlicht. Dort ist auch wieder die Anmeldung möglich sein.
Folgendes wird wieder geboten:
- Technische Vorträge
- Workshops
- Imagine Cup 2008 – Deutschland Finale
- Kontakte zu anderen Studierenden, Sprechern und potentiellen Arbeitgebern
Wer mehr über die STC erfahren möchte, kann auch meinen Bericht zur Student Technology Conference 2007 lesen.
Tags:
Berlin,
Imagine Cup 2008,
Kalkscheune Berlin,
stc,
Student Technology Conference
Am 15.02.2008 findet von 13 – 17 Uhr in der Universität Leipzig ein kostenloser Workshop von Jens Korte zum Vorgehensmodell SCRUM in Verbindung mit dem Team Foundation Server statt.
Weitere Informationen im Blog von Torsten Weber.
Tags:
.NET User Group Leipzig,
Agile Softwareentwicklung,
SCRUM,
Team Foundation Server,
Workshop
In dieser und der letzten Woche haben ich zwei Vorlesungen an der BA Heidenheim gehalten. Beide Vorlesungen wurden als Blockseminar veranstaltet und gingen jeweils über zwei Tage. In der ersten Veranstaltung mit dem Titel “ERP-Systeme: Microsoft Dynamics Nav” bin ich auf die aktuelle Navision-Version 5.0 eingegangen und habe die Finanzbuchhaltung sowie die Lagerverwaltung mehr oder weniger aus Anwendersicht erkärt. Im weiteren Verlauf der Veranstaltung habe ich dann noch einen Ausblick auf Microsoft Dynamics Nav 6.0 gegeben und versucht eine Diskussion über das Thema “Dynamics oder SAP – Wer gewinnt den Mittelstand” anzuregen.
Im zweiten Blockseminar wurde es dann wesentlich technischer – es ging um “Web-ERP Kopplung” am Beispiel von Dynamics NAV. Die Teilnehmer waren Studenten der Wirschaftsinformatik im 5.ten Semester. Ziel der Veranstaltung war den Studenten das nötige Wissen zu vermitteln, so dass sie ihr Webshop-Projekt an Navision anbinden können. Interessant war in dem Zusammenhang die Diskussion über die Wahl des Integrationsweges. Reicht eine Sammlung von einfachen Dataports, die in regelmäßigen Abständen manuell ausgeführt werden? Sollte man evtl. den Navision Application Server einsetzten und die Dataports automatisch ausführen lassen? Oder geht man im Sinne einer serviceorientierten Architektur sogar soweit, dass man ein Reihe von Webservices in den NAS integriert.
Insgesamt war es eine interessante Erfahrung mal den Vorlesungsbetrieb von der anderen Seite zu erleben. Ich musste erkennen wie schwierig es ist die Motivation der Teilnehmer für ein Thema über eine längere Zeit hoch zu halten.
Die Vortragsfolien werden diesmal nicht öffentlich zum Download angeboten, sondern nur für Teilnehmer passwortgeschützt per E-Mail geschickt.
Tags:
BA Heidenheim,
Dynamics NAV 6.0,
dynamics-nav,
microsoft,
navison,
sap,
SOA,
Vorlesung,
webservices,
webshop
“Was ist 2 mal 2 ?”
Der Ingenieur (zückt seinen Taschenrechner, rechnet ein bißchen…): “3,999999999”
Der Physiker: “In der Größenordnung von ein mal 10 hoch eins.”
Der Mathematiker (verzieht sich einen Tag in seine Stube, kommt dann freudestrahlend mit einem dicken Bündel Papier an): “Es existiert eine Lösung, und sie ist eindeutig!”
Der Psychiater: “Weiß ich nicht, aber gut, daß wir darüber geredet haben…”
Der Buchhalter (schließt alle Türen und Fenster und sieht sich vorsichtig um): “Was für eine Antwort wollen Sie hören?”
Der Jurist: “4, aber ich weiß nicht, ob wir vor Gericht damit durchkommen.”
Der Politiker: “Ich verstehe ihre Frage nicht…”
Der Mediziner: “4” – Alle anderen: “Pffft! Auswendig gelernt!”
Tags:
universität,
witze